Comparación de medias
¿Los distintos grupos piensan distinto? ¿Los jóvenes se ubican más a la izquierda que los mayores? ¿Los diputados oficialistas y los opositores valoran igual un tratado de libre comercio? Para responder preguntas así comparamos promedios entre grupos, y después nos preguntamos dos cosas: si la diferencia probablemente existe y si es lo bastante grande como para que importe.
Cómo trabajar con esta página
- Bloques 1, 2 y 3 Obligatorios · en orden — los tres videos con la explicación: para qué sirve y cómo se lee la tabla; el test; y cuándo una diferencia importa.
- Paso a paso — tres ejemplos resueltos y casos para trabajar en clase.
- Ejercicios — banco de práctica con respuestas desplegables.
- Bloque 4 — leer la salida de un programa estadístico.
- Bloque 5 — una investigación real.
- Podcast — “Significativo no es importante” (complementario).
- R y SPSS — el código completo para reproducir y modificar todos los ejemplos.
La receta
Datos
Latinobarómetro 2017 (Argentina, unas 1.200 personas) y Proyecto de Elites Parlamentarias de América Latina, PELA-USAL (diputados argentinos, cohorte 2017). Todos los resultados usan las bases ponderadas.
Para profundizar (optativo)
Wasserstein, R. L. y Lazar, N. A. (2016). “The ASA Statement on p-Values: Context, Process, and Purpose”. The American Statistician, 70(2), 129-133. La declaración de la Asociación Estadística Estadounidense sobre los usos y abusos del p.
Bloque 1 · ¿Para qué sirve comparar medias?
Qué variables se necesitan, qué herramienta corresponde según el tipo de variables y cómo se arma y se lee una tabla de promedios.
Bloque 2 · ¿Diferencia real o casualidad?
El test: prueba t y ANOVA, cómo se lee el p en SPSS y por qué “no significativa” no quiere decir “iguales”.
Bloque 3 · ¿La diferencia importa?
La regla del 5%, la grilla de tres casilleros, más de dos grupos, la lectura trampa y la perlita de eta cuadrado.
Ejemplo guiado 1 · Significativa y grande
“¿Ud. aprueba o no aprueba la gestión del gobierno que encabeza el presidente?”
| Aprobación de la gestión | Promedio | Casos |
|---|---|---|
| Aprueban la gestión | 5,86 | 392 |
| No aprueban la gestión | 8,22 | 709 |
La variable que depende es la corrupción percibida (un número de 0 a 10) y la que explica es la aprobación de la gestión (dos grupos). Quienes no aprueban la gestión le ponen, en promedio, 8,22; quienes la aprueban, 5,86. Los dos grupos tienen muchos casos (392 y 709).
Con dos grupos, el programa hace una prueba t. En SPSS:
| N | Media | Desv. estándar | Media de error estándar | ||
|---|---|---|---|---|---|
| Corrupción: Gobierno Nacional | Aprueba | 392 | 5,86 | 2,949 | ,149 |
| No aprueba | 709 | 8,22 | 2,237 | ,084 |
| Prueba de Levene | Prueba t para la igualdad de medias | |||||
|---|---|---|---|---|---|---|
| F | Sig. | t | gl | Sig. (bilateral) | Diferencia de medias | |
| Se asumen varianzas iguales | 52,670 | ,000 | -14,933 | 1099 | ,000 | -2,362 |
| No se asumen varianzas iguales | -13,816 | 643,826 | ,000 | -2,362 | ||
Leemos la fila “No se asumen varianzas iguales” y la columna Sig. (bilateral): ,000. Eso quiere decir p < 0,001 (no es cero). Es menor a 0,05: la diferencia es significativa, probablemente existe también en toda la población.
PASO 1. Promedios por grupo (ponderados)
                 grupo casos promedio desvio
    Aprueba la gestión   392     5.86   2.95
 No aprueba la gestión   709     8.22   2.24

PASO 2. El test
Prueba t: t = -13.82; gl = 643.8
p = menor a 0,001
-> p es menor a 0,05: la diferencia probablemente existe.

PASO 3. ¿La diferencia importa?
Diferencia entre el promedio más alto y el más bajo: 2,36 puntos
Diferencia ÷ promedio más bajo: 2,36 ÷ 5,86 = 40,3 %
-> Supera el 5%: la diferencia IMPORTA.La diferencia es 8,22 − 5,86 = 2,36 puntos. La dividimos por el promedio más bajo: 2,36 ÷ 5,86 = 40%. Supera largamente el 5%. La diferencia importa.
Ejemplo guiado 2 · Significativa pero chiquita
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 7,40 | 551 |
| Mujeres | 7,76 | 609 |
Las mujeres le ponen 7,76 y los varones 7,40. Los dos grupos están muy arriba en la escala: los dos ven mucha corrupción en la Justicia.
| N | Media | Desv. estándar | Media de error estándar | ||
|---|---|---|---|---|---|
| Corrupción: Tribunales de Justicia | Varones | 551 | 7,40 | 2,252 | ,096 |
| Mujeres | 609 | 7,76 | 2,286 | ,093 |
| Prueba de Levene | Prueba t para la igualdad de medias | |||||
|---|---|---|---|---|---|---|
| F | Sig. | t | gl | Sig. (bilateral) | Diferencia de medias | |
| Se asumen varianzas iguales | ,004 | ,949 | -2,721 | 1158 | ,007 | -,363 |
| No se asumen varianzas iguales | -2,723 | 1149,867 | ,007 | -,363 | ||
Fila “No se asumen varianzas iguales”: Sig. (bilateral) = ,007. Es menor a 0,05: la diferencia es significativa.
PASO 1. Promedios por grupo (ponderados)
   grupo casos promedio desvio
 Varones   551     7.40   2.25
 Mujeres   609     7.76   2.29

PASO 2. El test
Prueba t: t = -2.72; gl = 1149.9
p = 0,007
-> p es menor a 0,05: la diferencia probablemente existe.

PASO 3. ¿La diferencia importa?
Diferencia entre el promedio más alto y el más bajo: 0,36 puntos
Diferencia ÷ promedio más bajo: 0,36 ÷ 7,40 = 4,9 %
-> No llega al 5%: existe, pero es tan chica que NO IMPORTA.
Diferencia: 7,76 − 7,40 = 0,36. Dividida por el promedio más bajo: 0,36 ÷ 7,40 = 4,9%. No llega al 5%. Existe, pero es tan chica que no importa.
¿Por qué da significativa algo tan chico? Porque hay más de mil casos: con tantos casos, el test detecta hasta las diferencias más pequeñas.
Ejemplo guiado 3 · Más de dos grupos (ANOVA)
| Edad | Promedio | Casos |
|---|---|---|
| 16 a 25 | 4,83 | 177 |
| 26 a 40 | 4,95 | 320 |
| 41 a 60 | 5,37 | 320 |
| 61 y más | 6,14 | 225 |
Cuanta más edad, más a la derecha se ubican en promedio: de 4,83 en los más jóvenes a 6,14 en los mayores.
Con más de dos grupos, el programa hace un ANOVA. En SPSS (procedimiento Medias, con la opción “Tabla de ANOVA y eta”):
| Edad | Media | N | Desv. estándar |
|---|---|---|---|
| 16 a 25 | 4,83 | 177 | 2,021 |
| 26 a 40 | 4,95 | 320 | 2,397 |
| 41 a 60 | 5,37 | 320 | 2,380 |
| 61 y más | 6,14 | 225 | 2,478 |
| Total | 5,31 | 1041 | 2,395 |
| Suma de cuadrados | gl | Media cuadrática | F | Sig. | ||
|---|---|---|---|---|---|---|
| Autoubicación * Edad | Entre grupos (Combinado) | 236,563 | 3 | 78,854 | 14,277 | ,000 |
| Dentro de grupos | 5729,569 | 1037 | 5,523 | |||
| Total | 5966,132 | 1040 | ||||
| Eta | Eta cuadrado | |
|---|---|---|
| Autoubicación * Edad | ,199 | ,040 |
En la tabla de ANOVA leemos la fila “Entre grupos” y la columna Sig.: ,000 → p < 0,001. Significativa: al menos algún grupo se ubica distinto de los demás (no necesariamente todos: 16 a 25 y 26 a 40 casi no se diferencian).
PASO 1. Promedios por grupo (ponderados)
    grupo casos promedio desvio
  16 a 25   177     4.83   2.02
  26 a 40   320     4.95   2.40
  41 a 60   320     5.37   2.38
 61 y más   225     6.14   2.48

PASO 2. El test
ANOVA: F = 14.28
p = menor a 0,001
-> p es menor a 0,05: la diferencia probablemente existe.

PASO 3. ¿La diferencia importa?
Diferencia entre el promedio más alto y el más bajo: 1,31 puntos
Diferencia ÷ promedio más bajo: 1,31 ÷ 4,83 = 27,1 %
-> Supera el 5%: la diferencia IMPORTA.

(Perlita) Eta cuadrado: el grupo explica el 4 % de las diferencias entre las personas.Con varios grupos tomamos la distancia entre el promedio más alto y el más bajo: 6,14 − 4,83 = 1,31, y la dividimos por el más bajo: 1,31 ÷ 4,83 = 27%. Supera el 5%. La diferencia importa.
Casos para trabajar en clase
En grupos: aplicá los tres pasos, decidí en qué casillero de la grilla cae cada caso y redactá una conclusión. Después abrí la respuesta.
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 6,12 | 557 |
| Mujeres | 6,11 | 615 |
¿En qué casillero cae? ¿Se puede concluir que varones y mujeres opinan igual?
No significativa (p = 0,920, muy lejos de 0,05). No seguimos leyendo: no hay evidencia de que varones y mujeres difieran.
No se puede concluir que opinan igual: “no significativa” quiere decir que no hay evidencia suficiente para afirmar que son distintos, no que sean iguales.
| Ideología | Promedio | Casos |
|---|---|---|
| Izquierda | 2,18 | 21 |
| Centro | 4,19 | 21 |
| Derecha | 6,40 | 13 |
¿Qué test corresponde? ¿En qué casillero cae? ¿Te sorprende el resultado con tan pocos casos?
Tres grupos → ANOVA. p < 0,001: significativa. Diferencia entre el más alto y el más bajo: 6,40 − 2,18 = 4,22; dividida por el más bajo, 4,22 ÷ 2,18 = 194%. Importa (y mucho).
Aunque son poco más de 50 diputados, la diferencia es tan grande que el test la detecta igual: con pocos casos solo se ven las diferencias grandes, pero las grandes se ven.
Perlita Eta cuadrado = 36%: la ideología explica más de un tercio de las diferencias entre diputados en la valoración del tratado.
| Sexo | Promedio | Casos |
|---|---|---|
| Diputados | 7,84 | 34 |
| Diputadas | 8,79 | 19 |
La diferencia es casi de un punto. ¿Se puede afirmar que las diputadas apoyan más el matrimonio igualitario que los diputados?
No. p = 0,128: no significativa. Con tan pocos casos no hay evidencia suficiente para afirmar que la diferencia exista entre todos los diputados. No seguimos leyendo, aunque la diferencia (0,95) parezca grande.
Compará con el ejemplo guiado 2: allí una diferencia de 0,36 sí daba significativa, porque había más de mil casos. El p depende de cuántos casos hay; no mide el tamaño.
Mirá también la salida de SPSS: en este caso las dos filas dan distinto (0,190 y 0,128). Leemos siempre la de abajo.
| N | Media | Desv. estándar | Media de error estándar | ||
|---|---|---|---|---|---|
| Matrimonio igualitario | Diputados | 34 | 7,84 | 2,882 | ,494 |
| Diputadas | 19 | 8,79 | 1,614 | ,371 |
| Prueba de Levene | Prueba t para la igualdad de medias | |||||
|---|---|---|---|---|---|---|
| F | Sig. | t | gl | Sig. (bilateral) | Diferencia de medias | |
| Se asumen varianzas iguales | 5,835 | ,019 | -1,329 | 51 | ,190 | -,956 |
| No se asumen varianzas iguales | -1,548 | 50,966 | ,128 | -,956 | ||
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 6,95 | 89 |
| Mujeres | 7,43 | 103 |
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 7,44 | 170 |
| Mujeres | 8,02 | 190 |
Un compañero concluye: “En los jóvenes el sexo no influye en cómo ven la Justicia; en los adultos, sí”. ¿Estás de acuerdo?
No. La diferencia entre mujeres y varones es casi la misma en los dos grupos de edad (0,48 y 0,58: alrededor de medio punto). Lo que cambia es la cantidad de casos: 192 jóvenes contra 360 adultos. Con más casos, el test es más sensible.
Que una diferencia dé significativa y la otra no no prueba que los dos grupos de edad se comporten distinto. No se comparan los p entre sí: hay que comparar las diferencias.
| Gobierno / oposición | Promedio | Casos |
|---|---|---|
| Oficialistas | 6,01 | 19 |
| Opositores | 2,85 | 36 |
Aplicá los tres pasos. ¿Qué tiene en común este resultado con el del ejemplo guiado 1?
Dos grupos → prueba t. p < 0,001: significativa. Diferencia 6,01 − 2,85 = 3,16; dividida por el más bajo, 3,16 ÷ 2,85 = 111%. Importa.
En los dos casos, estar del lado del gobierno cambia mucho cómo se ven las cosas: los ciudadanos que aprueban la gestión ven menos corrupción en el gobierno, y los diputados oficialistas valoran mucho mejor un tratado que impulsaba la agenda del gobierno de ese momento. La misma lógica aparece en las elites y en la ciudadanía.
Banco de ejercicios
Resolvé cada ejercicio antes de abrir la respuesta. Los números salen de las bases ponderadas.
¿Se puede comparar medias?
Latinobarómetro 2017: “Con una escala de 1 a 10, le pedimos evaluar cuán democrático es Argentina…” y “Sexo del entrevistado”.
¿Qué herramienta usarías? ¿Por qué?
Latinobarómetro 2017: “¿Ud. aprueba o no aprueba la gestión del gobierno…?” (Aprueba / No aprueba) y “Sexo del entrevistado”.
¿Qué herramienta usarías? ¿Por qué?
Latinobarómetro 2017: autoubicación izquierda (0) – derecha (10) y “Edad del entrevistado” (en años cumplidos).
¿Qué herramienta usarías? ¿Por qué?
Latinobarómetro 2017: “¿Cuánta confianza tiene usted en… las Fuerzas Armadas?” (Mucha / Algo / Poca / Ninguna) y “¿Ud. aprueba o no aprueba la gestión del gobierno…?”.
¿Qué herramienta usarías? ¿Por qué?
PELA 2017: “¿Podría decirme si está Ud. más a favor de una economía regulada por el Estado o por el mercado?” (1 = máxima regulación del Estado, 10 = máxima liberación del mercado) e ideología (izquierda / centro / derecha).
¿Qué herramienta usarías? ¿Por qué?
PELA 2017: “Indique en la siguiente escala su opinión personal respecto al aborto” (1 = en contra, 10 = a favor) y “¿Es Ud. creyente?” (Sí / No).
¿Qué herramienta usarías? ¿Por qué?
Latinobarómetro 2017: “Si este domingo hubiera elecciones, ¿por qué partido votaría Ud.?” y región del país.
¿Qué herramienta usarías? ¿Por qué?
Latinobarómetro 2017: corrupción en el Gobierno Nacional (0 a 10) y corrupción en los Tribunales de Justicia (0 a 10).
¿Qué herramienta usarías? ¿Por qué?
Títulos y variables
¿Cuál es la variable que depende y cuál la que explica? ¿Qué más informa el título?
PELA 2017: opinión sobre el aborto (1 = en contra, 10 = a favor) comparada entre diputados creyentes y no creyentes.
Redactá el título de la tabla de promedios.
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 7,40 | 551 |
| Mujeres | 7,76 | 609 |
¿Qué representa el 551? ¿Por qué conviene mirarlo antes de interpretar el 7,40?
Leer la salida
| N | Media | Desv. estándar | Media de error estándar | ||
|---|---|---|---|---|---|
| Corrupción: Tribunales de Justicia | Varones | 551 | 7,40 | 2,252 | ,096 |
| Mujeres | 609 | 7,76 | 2,286 | ,093 |
| Prueba de Levene | Prueba t para la igualdad de medias | |||||
|---|---|---|---|---|---|---|
| F | Sig. | t | gl | Sig. (bilateral) | Diferencia de medias | |
| Se asumen varianzas iguales | ,004 | ,949 | -2,721 | 1158 | ,007 | -,363 |
| No se asumen varianzas iguales | -2,723 | 1149,867 | ,007 | -,363 | ||
¿Qué fila leés? ¿Cuál es el p? ¿La diferencia es significativa?
En la salida de SPSS de la corrupción en el Gobierno Nacional según la gestión, la columna Sig. (bilateral) dice ,000. Un compañero escribe en su informe: “p = 0”.
¿Está bien?
| Ideología | Media | N | Desv. estándar |
|---|---|---|---|
| Izquierda | 2,18 | 21 | 1,712 |
| Centro | 4,19 | 21 | 2,623 |
| Derecha | 6,40 | 13 | 2,243 |
| Total | 3,94 | 54 | 2,725 |
| Suma de cuadrados | gl | Media cuadrática | F | Sig. | ||
|---|---|---|---|---|---|---|
| Valoración TLC EE.UU. * Ideología | Entre grupos (Combinado) | 142,714 | 2 | 71,357 | 14,457 | ,000 |
| Dentro de grupos | 253,534 | 51 | 4,936 | |||
| Total | 396,248 | 53 | ||||
| Eta | Eta cuadrado | |
|---|---|---|
| Valoración TLC EE.UU. * Ideología | ,600 | ,360 |
¿Qué test se hizo? ¿Dónde está el p y qué decís? ¿Cuánto vale eta cuadrado y cómo se lee?
| N | Media | Desv. estándar | Media de error estándar | ||
|---|---|---|---|---|---|
| Matrimonio igualitario | Diputados | 34 | 7,84 | 2,882 | ,494 |
| Diputadas | 19 | 8,79 | 1,614 | ,371 |
| Prueba de Levene | Prueba t para la igualdad de medias | |||||
|---|---|---|---|---|---|---|
| F | Sig. | t | gl | Sig. (bilateral) | Diferencia de medias | |
| Se asumen varianzas iguales | 5,835 | ,019 | -1,329 | 51 | ,190 | -,956 |
| No se asumen varianzas iguales | -1,548 | 50,966 | ,128 | -,956 | ||
Las dos filas dan un p distinto. ¿Cuál usás y qué concluís?
La grilla: ¿en qué casillero cae?
| Gestión | Promedio | Casos |
|---|---|---|
| Aprueban la gestión | 6,04 | 396 |
| No aprueban la gestión | 6,92 | 694 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 2,61 | 502 |
| Mujeres | 1,74 | 519 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Gestión | Promedio | Casos |
|---|---|---|
| Aprueban la gestión | 7,43 | 377 |
| No aprueban la gestión | 7,82 | 665 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Sexo | Promedio | Casos |
|---|---|---|
| Varones | 8,31 | 537 |
| Mujeres | 8,16 | 575 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Intención de voto | Promedio | Casos |
|---|---|---|
| Votarían al FPV | 6,45 | 143 |
| Votarían a Cambiemos | 2,75 | 160 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Intención de voto | Promedio | Casos |
|---|---|---|
| Votarían al FPV | 5,58 | 163 |
| Votarían a Cambiemos | 6,99 | 174 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Educación | Promedio | Casos |
|---|---|---|
| Educación baja | 5,69 | 381 |
| Educación media | 5,34 | 383 |
| Educación alta | 4,76 | 278 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Gestión | Promedio | Casos |
|---|---|---|
| Aprueban la gestión | 7,22 | 394 |
| No aprueban la gestión | 7,65 | 707 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Educación | Promedio | Casos |
|---|---|---|
| Educación baja | 7,35 | 438 |
| Educación media | 7,49 | 402 |
| Educación alta | 7,24 | 286 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Edad | Promedio | Casos |
|---|---|---|
| 16 a 25 | 6,19 | 183 |
| 26 a 40 | 6,55 | 337 |
| 41 a 60 | 6,93 | 349 |
| 61 y más | 6,63 | 261 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Ideología | Promedio | Casos |
|---|---|---|
| Izquierda | 2,87 | 21 |
| Centro | 5,20 | 21 |
| Derecha | 5,47 | 13 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Creyente | Promedio | Casos |
|---|---|---|
| Creyentes | 4,03 | 44 |
| No creyentes | 8,34 | 9 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Sexo | Promedio | Casos |
|---|---|---|
| Diputados | 4,30 | 34 |
| Diputadas | 4,07 | 19 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Ideología | Promedio | Casos |
|---|---|---|
| Izquierda | 5,26 | 21 |
| Centro | 6,36 | 21 |
| Derecha | 5,31 | 13 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Gobierno / oposición | Promedio | Casos |
|---|---|---|
| Oficialistas | 7,02 | 19 |
| Opositores | 4,75 | 35 |
Aplicá los tres pasos. ¿En qué casillero cae?
| Sexo | Promedio | Casos |
|---|---|---|
| Diputados | 4,47 | 35 |
| Diputadas | 4,27 | 20 |
Aplicá los tres pasos. ¿En qué casillero cae?
Errores de interpretación
“Como en ‘cuán democrático es el país’ según sexo el p es 0,92, varones y mujeres opinan igual.”
¿Es correcta esta conclusión?
“Como p = 0,007, la diferencia entre varones y mujeres en la corrupción que perciben en la Justicia es importante.”
¿Es correcta?
“La diferencia en corrupción en el gobierno según la gestión tiene p < 0,001 y la de la Justicia según sexo tiene p = 0,007. Como el primer p es más chico, la primera diferencia es más importante.”
¿El razonamiento es correcto?
“En el ANOVA de la autoubicación según la edad dio p < 0,001; por lo tanto, los cuatro grupos de edad se ubican distinto entre sí.”
¿Es correcta?
“Entre los diputados, las diputadas aprueban más el matrimonio igualitario que los diputados (8,79 contra 7,84).”
¿Se puede afirmar?
“En los jóvenes, la diferencia por sexo en la corrupción que ven en la Justicia no es significativa (p = 0,138); en los adultos de 41 a 60, sí (p = 0,015). Entonces el sexo pesa más entre los adultos.”
¿Es correcta?
Perlita: eta cuadrado
Eta cuadrado de la valoración del TLC con EE.UU. según gobierno u oposición (diputados): 31%. Eta cuadrado de la corrupción en el Gobierno Nacional según la aprobación de la gestión (ciudadanos): 17%.
¿Cómo se lee cada número?
En la autoubicación según la edad, la diferencia (1,31) importa según la regla del 5%, pero eta cuadrado es apenas 4%.
¿Hay una contradicción?
Tu turno con R o SPSS
PELA 2017. Con el script de R o la sintaxis de SPSS, compará la preferencia Estado (1) – mercado (10) según se consideren del gobierno o de la oposición (variable POL1). Aplicá los tres pasos y redactá una conclusión.
R: comparar_dos_grupos(pela$EM1, pela$gob_opo, pela$Ponder) · SPSS: T-TEST GROUPS=POL1(1 2) /VARIABLES=EM1.
Oficialistas 5,86, opositores 3,63. p < 0,001: significativa. Diferencia 2,23, que es un 61,4% del promedio más bajo: importa. Los diputados oficialistas se ubican bastante más cerca del mercado que los opositores.
Latinobarómetro 2017. Compará cuán democrático es el país (1 a 10) según la aprobación de la gestión (P17STGBSC). Aplicá los tres pasos.
R: comparar_dos_grupos(lb$P11STGBSC, lb$gestion, lb$WT) · SPSS: T-TEST GROUPS=P17STGBSC(1 2) /VARIABLES=P11STGBSC.
Aprueban 6,99, no aprueban 5,62. p < 0,001: significativa. Diferencia 1,37, que es un 24,4% del promedio más bajo: importa. Quienes aprueban la gestión ven al país bastante más democrático.
Bloque 4 · Leer la salida de un programa estadístico
Antes de leer, escuchá la presentación del bloque (unos 3 minutos).
¿Hay diferencias en los ingresos promedio entre varones y mujeres?
Vamos a leer una salida de SPSS que compara los ingresos promedio de varones y mujeres, con datos ponderados. Los ingresos están expresados en unidades monetarias ilustrativas: lo importante no es la moneda, sino aprender a leer los resultados.
¿Qué estamos comparando?
Lo primero es identificar las variables:
- Variable dependiente: ingresos totales. Es un número, así que se puede promediar.
- Variable independiente: sexo, con dos grupos: varones y mujeres.
Un número y una variable que arma grupos: es un caso de comparación de medias. Queremos ver si el ingreso promedio cambia de un grupo a otro.
¿Qué muestran los promedios?
La primera tabla de la salida trae los promedios (en inglés, Mean) de cada grupo:
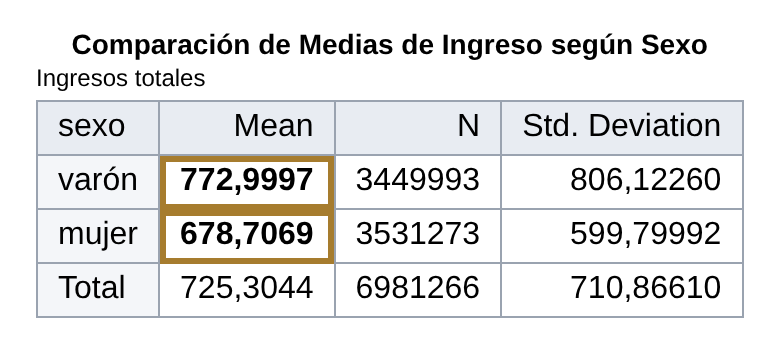
| Grupo | Ingreso promedio |
|---|---|
| Varones | 773 |
| Mujeres | 679 |
| Diferencia | 94 |
Los varones ganan en promedio unas 773 unidades y las mujeres, 679: una diferencia de unas 94 unidades.
Hasta acá solo describimos los datos: sabemos qué grupo tiene el promedio más alto y cuánto es la diferencia. Todavía no sabemos si esa diferencia probablemente existe en toda la población o si podría ser casualidad de la muestra.
¿Qué dice el test?
La segunda tabla se llama ANOVA Table. De toda la tabla, lo único que miramos es la columna Sig., que es el p:
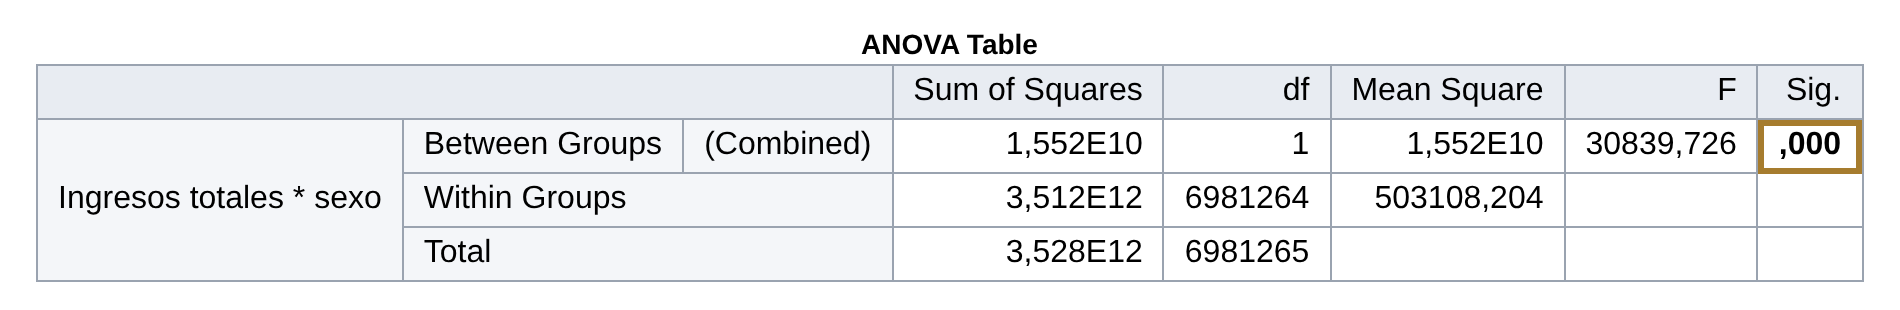
Sig. = ,000. Esto no quiere decir que p sea cero: quiere decir que p es menor a 0,001. Es menor a 0,05, así que la diferencia es significativa: probablemente existe también en toda la población.
El test nos dice si la diferencia probablemente existe. No nos dice si es grande o si importa: eso es el paso siguiente.
¿La diferencia importa?
Aplicamos la regla del curso: la diferencia importa si supera el 5% del promedio más bajo, que acá es el de las mujeres:
94 ÷ 679 = 0,138 → casi 14%
Los varones ganan en promedio casi un 14% más que las mujeres. Supera largamente el 5%: la diferencia importa.
La salida trae una tercera tabla, Measures of Association. Ahí miramos solo la columna Eta Squared (eta cuadrado):
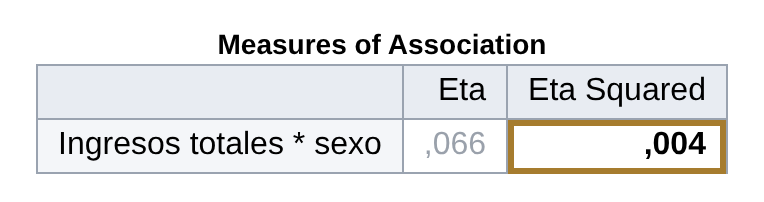
Eta cuadrado = ,004, es decir, 0,4%. Se lee así: el sexo explica el 0,4% de las diferencias de ingreso entre las personas. Es muy poco, porque los ingresos varían muchísimo dentro de los varones y dentro de las mujeres: hay varones y mujeres con ingresos muy bajos y muy altos.
Eso no vuelve irrelevante la diferencia. Que, en promedio, los varones ganen casi un 14% más que las mujeres es un dato muy importante en términos sociales y políticos. Para decidir si la diferencia importa usamos la regla del 5%; eta cuadrado es un dato más para comentar.
Entonces, ¿qué podemos concluir?
- Diferencia: los varones ganan en promedio unas 94 unidades más que las mujeres.
- Test: p < 0,001. La diferencia es significativa: probablemente existe en toda la población.
- ¿Importa? Sí: es casi un 14% del ingreso promedio de las mujeres, mucho más que el 5%.
- Perlita: el sexo explica el 0,4% de las diferencias de ingreso entre las personas.
Lo que no podemos decir: esta comparación muestra que los ingresos son distintos según el sexo, pero no prueba que el sexo, por sí solo, cause esa diferencia, ni explica por qué ocurre. Para eso harían falta otros datos y otros análisis.
Para recordar
Al leer cualquier salida de comparación de medias, seguí este recorrido:
- ¿Cuál es la variable dependiente (el número) y cuál la independiente (los grupos)?
- ¿Cuánto difieren los promedios? ¿Cuántos casos hay en cada grupo?
- ¿El test da significativo (Sig. menor a 0,05)? Si no, no se sigue leyendo.
- ¿La diferencia supera el 5% del promedio más bajo?
- ¿Qué permite concluir el análisis y qué no?
Bloque 5 · Una investigación real
Antes de leer, escuchá la presentación del bloque (unos 3 minutos).
De qué se trata
El artículo estudia la disciplina partidaria en el Congreso argentino entre 2007 y 2019: cuánto votan los legisladores de manera alineada con su partido, y qué papel juegan los gobernadores en esa disciplina. Para medirla, los autores usan el índice IT (Independencia-Territorialidad), calculado a partir de las votaciones nominales de cada proyecto de ley.
Trabajá con las tres tablas de abajo. Respondé cada pregunta antes de abrir el análisis.
Las tablas
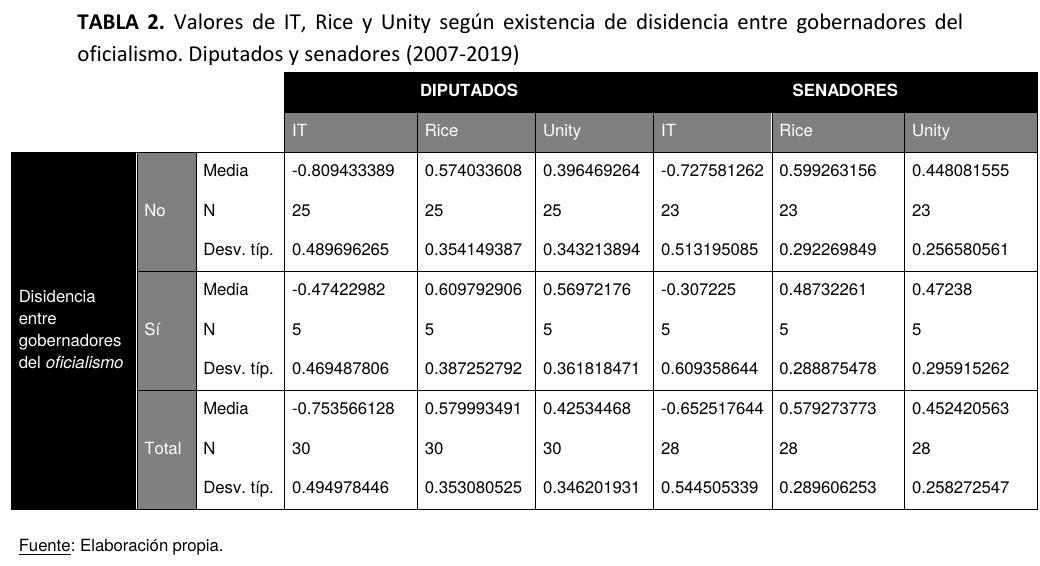
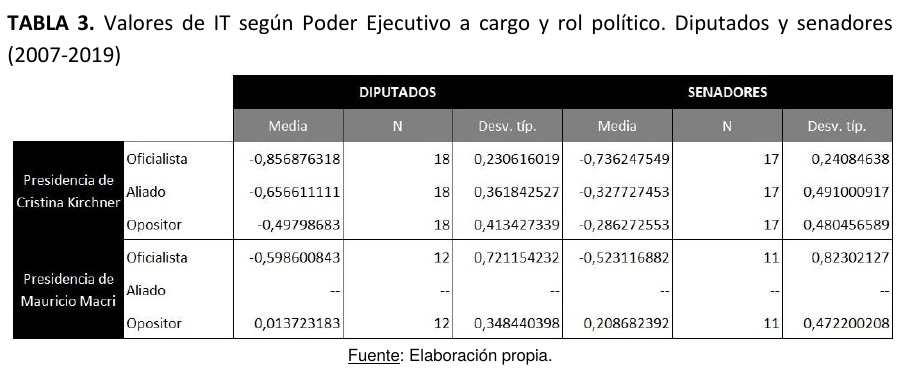
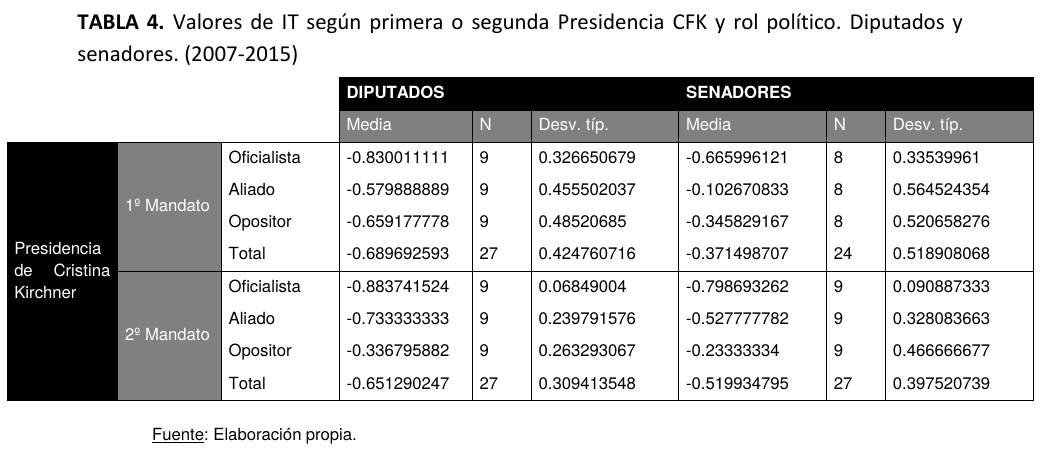
Fuente: Zamichiei, Coronel y Gutiérrez Guerra (2020), Tablas 2, 3 y 4. En la Tabla 2 trabajamos solo con la columna IT.
Preguntas guiadas
Antes de mirar los números: los casos de esta investigación son todos los proyectos de ley de 2007 a 2019 que se votaron nominalmente y en los que se pudo conocer la postura de los gobernadores. ¿Es una muestra o es el universo? ¿Qué cambia eso en la receta de los tres pasos?
Es el universo, no una muestra. No se eligieron algunos proyectos al azar para inferir lo que pasa en el resto: se analizaron todos los que cumplían el criterio.
Eso cambia la receta: el test sirve para saber si una diferencia que vemos en una muestra probablemente existe en toda la población. Acá ya estamos mirando a toda la población de casos, así que no hay casualidad de la muestra que descartar y no hace falta el test. La diferencia que vemos es la diferencia que hay.
Pasamos directo del paso 1 (los promedios) al paso 3 (¿importa?).
Un matiz: el universo es el de los proyectos que cumplen el criterio, no el de todas las votaciones del Congreso. Las conclusiones valen para ese conjunto.
En la Tabla 3, ¿cuál es la variable dependiente y cuál la independiente? ¿Qué cuenta la columna N?
Variable dependiente: la disciplina partidaria, medida con el índice IT (un número de −1 a +1). Variable independiente: quién ejercía la presidencia (Cristina Kirchner o Mauricio Macri). Además, la tabla separa por rol político (oficialista, aliado, opositor) y por Cámara.
La N no cuenta personas: cuenta proyectos votados. Por ejemplo, 18 proyectos en Diputados durante la presidencia de Cristina Kirchner y 12 durante la de Macri. La unidad de análisis es el proyecto, no el legislador.
El índice IT tiene valores negativos. ¿Cómo aplicamos la regla del 5% del promedio más bajo?
Con valores negativos no se puede dividir directamente. La solución es correr el cero: lo ponemos en −1, la disciplina total, y medimos cuánto se aleja cada valor de ese punto. En la práctica, le sumamos 1 a cada valor: −0,857 pasa a ser 0,143; −0,599 pasa a ser 0,401; y un valor positivo como 0,014 pasa a ser 1,014.
Con los valores corridos aplicamos la regla de siempre: diferencia ÷ valor más bajo, y nos fijamos si supera el 5%. Correr el cero es una decisión del investigador, y conviene decirlo siempre.
Tabla 3. Compará la disciplina de los legisladores oficialistas bajo Cristina Kirchner y bajo Mauricio Macri, en Diputados y en el Senado. ¿Qué gobierno tuvo oficialistas más disciplinados? ¿La diferencia importa?
| Oficialistas | Cristina Kirchner | Mauricio Macri | Diferencia |
|---|---|---|---|
| Diputados | −0,857 (0,143) | −0,599 (0,401) | 0,258 → 180% |
| Senado | −0,736 (0,264) | −0,523 (0,477) | 0,213 → 81% |
Los oficialistas fueron más disciplinados bajo Cristina Kirchner (valores más cercanos a −1). Entre paréntesis, los valores con el cero corrido a −1. Las diferencias equivalen a un 180% y un 81% del valor más bajo: superan largamente el 5%, así que importan. Como es el universo, no hace falta preguntarse si “existen”: son las diferencias que hubo.
Tabla 3. Hacé lo mismo con los opositores. ¿Qué pasa con la oposición durante el gobierno de Macri? ¿Cómo se lee un valor cercano a 0?
| Opositores | Cristina Kirchner | Mauricio Macri | Diferencia |
|---|---|---|---|
| Diputados | −0,498 (0,502) | 0,014 (1,014) | 0,512 → 102% |
| Senado | −0,286 (0,714) | 0,209 (1,209) | 0,495 → 69% |
La oposición fue mucho menos disciplinada durante el gobierno de Macri: diferencias del 102% y del 69% del valor más bajo. Importan, y mucho.
Ojo con la lectura del valor cercano a 0: según los autores, no indica indisciplina total (que sería +1). Puede indicar una oposición partida en dos subgrupos muy disciplinados pero enfrentados entre sí: uno más duro con el gobierno y otro más dialoguista. El promedio “esconde” esa división.
Tabla 2 (columna IT). ¿Qué pasa con la disciplina cuando los gobernadores del oficialismo no están todos de acuerdo sobre un proyecto? ¿Importa la diferencia? ¿Hay algo en la columna N que obligue a leer con cuidado?
| IT | Sin disidencia | Con disidencia | Diferencia |
|---|---|---|---|
| Diputados | −0,809 (0,191) | −0,474 (0,526) | 0,335 → 176% |
| Senado | −0,728 (0,272) | −0,307 (0,693) | 0,420 → 154% |
Cuando hay disidencia entre los gobernadores oficialistas, la disciplina cae bastante: diferencias del 176% y del 154% del valor más bajo, muy por encima del 5%. Importan.
Pero hay que mirar la N: solo hubo 5 proyectos con disidencia, frente a 25 (Diputados) y 23 (Senado) sin disidencia. Un promedio calculado sobre 5 casos puede cambiar mucho con un solo proyecto distinto. Es un resultado interesante, que conviene seguir mirando a medida que haya más casos.
Tabla 4. ¿Los oficialistas fueron más disciplinados en el segundo mandato de Cristina Kirchner que en el primero? Aplicá la regla en cada Cámara y comparalo con lo que dice el artículo.
| Oficialistas | 1.º mandato | 2.º mandato | Diferencia |
|---|---|---|---|
| Diputados | −0,830 (0,170) | −0,884 (0,116) | 0,054 → 46% |
| Senado | −0,666 (0,334) | −0,799 (0,201) | 0,133 → 66% |
En las dos Cámaras la disciplina sube en el segundo mandato, y las dos diferencias superan el 5%: 46% en Diputados y 66% en el Senado. Importan.
Fijate que el artículo habla de “solamente un leve incremento” en Diputados. Medida en puntos del índice, la diferencia es chica (0,054). Pero los oficialistas ya estaban muy cerca de la disciplina total: cuando se está tan cerca del máximo, cualquier paso es proporcionalmente grande. Esa es la diferencia entre mirar la distancia en puntos y mirarla en relación con el punto de partida.
Tabla 3. Mirá los desvíos de los oficialistas en cada gobierno. ¿Qué agregan a la lectura de los promedios?
Bajo Cristina Kirchner los desvíos son chicos (0,23 en Diputados y 0,24 en el Senado): la disciplina fue alta y pareja en casi todos los proyectos. Bajo Macri son muy grandes (0,72 y 0,82): hubo proyectos con mucha disciplina y otros con muy poca. El promedio de −0,599 resume situaciones muy distintas entre sí.
Los propios autores lo advierten: el promedio puede estar “ocultando que nada es tan simple como parece”.
¿Se puede concluir que la persona del presidente causa el nivel de disciplina de su bloque?
No directamente. Los autores lo aclaran: la presidencia “no es necesariamente una variable explicativa per se”. La diferencia entre gobiernos puede deberse también al papel de los gobernadores, a la estructura de los partidos o a cómo estaba formado el gobierno. Por ejemplo, Macri gobernó con una coalición de partidos con identidades propias, lo que podría bajar la disciplina por sí solo. Comparar medias muestra diferencias asociadas a los grupos, no sus causas.
Para pensar: supongamos que estos mismos proyectos hubieran sido una muestra al azar de un conjunto mucho más grande. ¿Qué esperarías del test, con tan pocos casos y desvíos tan grandes?
Con 18 y 12 casos, y desvíos tan grandes en el gobierno de Macri, el test sería una lupa débil. Varias de estas diferencias, aunque superan el umbral, probablemente no darían significativas: no habría evidencia suficiente para afirmar que existen en la población.
Por eso es tan importante el primer paso de todo análisis: saber si trabajamos con una muestra o con el universo. Con el universo, la diferencia observada es la diferencia real y alcanza con preguntarse si importa. Con una muestra chica, primero hay que pasar por el test.
Para recordar
- Antes de cualquier test, preguntate: ¿es una muestra o es el universo?
- Si es el universo, no hace falta el test: la diferencia que ves es la que hay. Pasás directo a preguntarte si importa.
- Fijate qué cuenta la N: personas, proyectos, países, votaciones…
- Mirá también los desvíos: un promedio puede esconder situaciones muy distintas.
- Una diferencia entre grupos no prueba una causa.
Podcast: Significativo no es importante
Complementario al video. Alejandro y Valentina conversan sobre por qué un resultado puede ser significativo y, a la vez, no importar.
Script completo de R
Guardá el script y las dos bases en la misma carpeta. En RStudio: Session > Set Working Directory > To Source File Location, y corré de a un bloque. Las funciones del comienzo hacen todo el trabajo: abajo solo cambiás la variable, los grupos y la escala.
# =====================================================================
#  MÉTODOS CUANTITATIVOS — COMPARACIÓN DE MEDIAS
#  Script completo de R
#  Bases: Latinobarómetro Argentina 2017 y PELA Argentina 2017
#  Las dos bases se analizan PONDERADAS.
# =====================================================================
#
#  Cómo usarlo:
#  1. Guardá las dos bases (.csv) en la misma carpeta que este script.
#  2. En RStudio: Session > Set Working Directory > To Source File Location.
#  3. Corré el script de a un bloque por vez (Ctrl + Enter).
#
#  La receta de toda la clase, en tres pasos:
#  PASO 1. Mirar los promedios de cada grupo.
#  PASO 2. El test: ¿p es menor a 0,05?
#          Si NO -> no hay evidencia de diferencia. No se sigue leyendo.
#          Si SÍ -> la diferencia probablemente existe. Seguimos.
#  PASO 3. ¿Importa? ¿La diferencia supera el 5% del promedio más bajo?
#          Cálculo: diferencia ÷ promedio más bajo.
#  Ojo: para comparar escalas distintas (0 a 10 con 1 a 10), primero
#  hay que llevarlas a la misma escala.
# =====================================================================


# ---------------------------------------------------------------------
# 0. FUNCIONES DE AYUDA
#    No hace falta entender cómo están hechas por dentro: solo cómo
#    se usan (más abajo). Calculan lo mismo que SPSS con la base
#    ponderada y leyendo la fila "No se asumen varianzas iguales".
# ---------------------------------------------------------------------

resumen_ponderado <- function(y, grupo, peso) {
  ok <- !is.na(y) & !is.na(grupo) & !is.na(peso)
  y <- y[ok]; grupo <- droplevels(as.factor(grupo[ok])); peso <- peso[ok]
  tab <- do.call(rbind, lapply(levels(grupo), function(g) {
    yy <- y[grupo == g]; ww <- peso[grupo == g]
    n <- sum(ww); m <- sum(ww * yy) / n
    v <- sum(ww * (yy - m)^2) / (n - 1)
    data.frame(grupo = g, n = round(n), media = m, desvio = sqrt(v), var = v, n_exacto = n)
  }))
  list(tabla = tab, y = y, grupo = grupo, peso = peso)
}

# Para DOS grupos: prueba t (fila "No se asumen varianzas iguales")
comparar_dos_grupos <- function(y, grupo, peso) {
  r <- resumen_ponderado(y, grupo, peso)$tabla
  if (nrow(r) != 2) stop("Esta función es para dos grupos. Usá comparar_varios_grupos().")
  se <- sqrt(r$var[1] / r$n_exacto[1] + r$var[2] / r$n_exacto[2])
  t  <- (r$media[1] - r$media[2]) / se
  gl <- se^4 / ((r$var[1] / r$n_exacto[1])^2 / (r$n_exacto[1] - 1) +
                (r$var[2] / r$n_exacto[2])^2 / (r$n_exacto[2] - 1))
  p  <- 2 * pt(-abs(t), gl)
  informar(r, p, paste0("Prueba t: t = ", round(t, 2), "; gl = ", round(gl, 1)))
}

# Para MÁS DE DOS grupos: ANOVA de un factor
comparar_varios_grupos <- function(y, grupo, peso) {
  r <- resumen_ponderado(y, grupo, peso)$tabla
  N <- sum(r$n_exacto); k <- nrow(r)
  media_total <- sum(r$n_exacto * r$media) / N
  entre  <- sum(r$n_exacto * (r$media - media_total)^2)
  dentro <- sum((r$n_exacto - 1) * r$var)
  F <- (entre / (k - 1)) / (dentro / (N - k))
  p <- pf(F, k - 1, N - k, lower.tail = FALSE)
  informar(r, p, paste0("ANOVA: F = ", round(F, 2)),
           eta2 = entre / (entre + dentro))
}

informar <- function(r, p, detalle, eta2 = NULL) {
  dif <- max(round(r$media, 2)) - min(round(r$media, 2))
  cat("\n------------------------------------------------------------\n")
  cat("PASO 1. Promedios por grupo (ponderados)\n")
  print(data.frame(grupo = r$grupo, casos = r$n,
                   promedio = round(r$media, 2), desvio = round(r$desvio, 2)),
        row.names = FALSE)
  cat("\nPASO 2. El test\n")
  cat(detalle, "\n")
  cat("p =", ifelse(p < 0.001, "menor a 0,001", formatC(p, format = "f", digits = 3, decimal.mark = ",")), "\n")
  if (p >= 0.05) {
    cat("-> p NO es menor a 0,05: no hay evidencia de que los grupos difieran.\n")
    cat("   No seguimos leyendo la diferencia.\n")
  } else {
    cat("-> p es menor a 0,05: la diferencia probablemente existe.\n")
    cat("\nPASO 3. ¿La diferencia importa?\n")
    mas_bajo <- min(round(r$media, 2))
    porcentaje <- 100 * dif / mas_bajo
    cat("Diferencia entre el promedio más alto y el más bajo:", formatC(dif, format = "f", digits = 2, decimal.mark = ","),
        "puntos\n")
    cat("Diferencia ÷ promedio más bajo:", formatC(dif, format = "f", digits = 2, decimal.mark = ","), "÷",
        formatC(mas_bajo, format = "f", digits = 2, decimal.mark = ","), "=",
        formatC(porcentaje, format = "f", digits = 1, decimal.mark = ","), "%\n")
    if (porcentaje > 5) cat("-> Supera el 5%: la diferencia IMPORTA.\n")
    else cat("-> No llega al 5%: existe, pero es tan chica que NO IMPORTA.\n")
  }
  if (!is.null(eta2)) cat("\n(Perlita) Eta cuadrado: el grupo explica el",
                          format(round(100 * eta2, 1), decimal.mark = ","),
                          "% de las diferencias entre las personas.\n")
  cat("------------------------------------------------------------\n")
}

# Eta cuadrado para dos grupos (perlita)
eta_cuadrado <- function(y, grupo, peso) {
  r <- resumen_ponderado(y, grupo, peso)$tabla
  N <- sum(r$n_exacto); media_total <- sum(r$n_exacto * r$media) / N
  entre  <- sum(r$n_exacto * (r$media - media_total)^2)
  dentro <- sum((r$n_exacto - 1) * r$var)
  cat("Eta cuadrado:", format(round(100 * entre / (entre + dentro), 1), decimal.mark = ","),
      "% de las diferencias se explica por el grupo.\n")
}


# ---------------------------------------------------------------------
# 1. CARGA Y LIMPIEZA DE LAS BASES
# ---------------------------------------------------------------------

lb <- read.csv("Latinobarometro_2017_Argentina_Csv_esp_v1.csv",
               sep = ";", fileEncoding = "UTF-8-BOM", check.names = FALSE)
pela <- read.csv("SALAMANCA_COMPLETA_FINAL_2017_para_clases_y_PONDERADA.csv",
                 check.names = FALSE)

# Latinobarómetro: los códigos negativos son "no sabe", "no responde",
# "no conoce", etc. Los pasamos a NA (dato perdido).
for (v in c("P11STGBSC", "P19STC", "P42NC.A", "P42NC.B", "P42NC.C",
            "P42NC.D", "P42NC.E", "P42NC.F", "P61ST.1", "P61ST.2", "P61ST.3",
            "P17STGBSC")) {
  lb[[v]][lb[[v]] < 0] <- NA
}

# Grupos con nombre (Latinobarómetro)
lb$sexo     <- factor(lb$SEXO, levels = 1:2, labels = c("Varones", "Mujeres"))
lb$edad4    <- factor(lb$REEDAD, levels = 1:4,
                      labels = c("16 a 25", "26 a 40", "41 a 60", "61 y más"))
lb$gestion  <- factor(lb$P17STGBSC, levels = 1:2,
                      labels = c("Aprueba la gestión", "No aprueba la gestión"))
lb$educ3    <- cut(lb$"REEDUC.1", breaks = c(0, 3, 5, 7),
                   labels = c("Baja", "Media", "Alta"))
lb$voto     <- factor(lb$P16STGBS, levels = c(32001, 32044),
                      labels = c("FPV", "Cambiemos"))

# PELA: 98 = no sabe, 99 = no contesta, 999 = sin dato. Los pasamos a NA.
for (v in c("RRII2_US", "RRII2_UE", "VAL1", "VAL2", "VAL3", "EM1", "FFAA1")) {
  pela[[v]][pela[[v]] > 10] <- NA
}
pela$sexo     <- factor(pela$SOCD4, levels = 1:2, labels = c("Diputados", "Diputadas"))
pela$ideol3   <- factor(pela$IDEOL_5_3, levels = 1:3,
                        labels = c("Izquierda", "Centro", "Derecha"))
pela$gob_opo  <- factor(pela$POL1, levels = 1:2, labels = c("Oficialistas", "Opositores"))
pela$creyente <- factor(pela$RE1, levels = 1:2, labels = c("Creyentes", "No creyentes"))


# ---------------------------------------------------------------------
# 2. LOS CASOS DE LA CLASE
#    Formato: comparar_..._grupos(variable_numérica, grupos, ponderador)
# ---------------------------------------------------------------------

# CASO 1 — Significativa pero chiquita
# ¿Cuánta corrupción hay en los Tribunales de Justicia? (0 a 10) según sexo
comparar_dos_grupos(lb$"P42NC.A", lb$sexo, lb$WT)

# CASO 2 — Significativa y grande
# ¿Cuánta corrupción hay en el Gobierno Nacional? (0 a 10)
# según aprueba o no la gestión del gobierno
comparar_dos_grupos(lb$"P42NC.C", lb$gestion, lb$WT)

# CASO 3 — No significativa
# ¿Cuán democrático es el país? (1 a 10) según sexo
comparar_dos_grupos(lb$P11STGBSC, lb$sexo, lb$WT)

# CASO 4 — Más de dos grupos (ANOVA)
# Autoubicación izquierda (0) - derecha (10) según edad
comparar_varios_grupos(lb$P19STC, lb$edad4, lb$WT)

# CASO 5 — Grande aun con pocos casos (PELA, diputados)
# Valoración de un Tratado de Libre Comercio con EE.UU. (1 a 10) según ideología
comparar_varios_grupos(pela$RRII2_US, pela$ideol3, pela$Ponder)

# CASO 6 — Parece grande pero no alcanza (PELA)
# Aprobación del matrimonio entre personas del mismo sexo (1 a 10) según sexo
comparar_dos_grupos(pela$VAL1, pela$sexo, pela$Ponder)

# CASO 7 — La lectura trampa
# La misma pregunta del caso 1, por separado en dos grupos de edad
jovenes <- lb$REEDAD == 1
adultos <- lb$REEDAD == 3
comparar_dos_grupos(lb$"P42NC.A"[jovenes], lb$sexo[jovenes], lb$WT[jovenes])
comparar_dos_grupos(lb$"P42NC.A"[adultos], lb$sexo[adultos], lb$WT[adultos])
# En los dos grupos la diferencia es de alrededor de medio punto.
# En uno da significativa y en el otro no: eso NO quiere decir que
# el sexo "pese" distinto según la edad.

# CASO 8 — Paralelo elites / ciudadanos (PELA)
# Valoración del TLC con EE.UU. según oficialistas u opositores
comparar_dos_grupos(pela$RRII2_US, pela$gob_opo, pela$Ponder)


# ---------------------------------------------------------------------
# 3. PERLITA: ETA CUADRADO
#    Para más de dos grupos ya aparece en la salida de
#    comparar_varios_grupos(). Para dos grupos:
# ---------------------------------------------------------------------
eta_cuadrado(lb$"P42NC.C", lb$gestion, lb$WT)
eta_cuadrado(pela$RRII2_US, pela$gob_opo, pela$Ponder)


# ---------------------------------------------------------------------
# 4. CRUCES DEL BANCO DE EJERCICIOS
# ---------------------------------------------------------------------

# Latinobarómetro
comparar_dos_grupos(lb$"P61ST.3", lb$gestion, lb$WT)   # Papa Francisco x gestión
comparar_dos_grupos(lb$"P61ST.2", lb$sexo, lb$WT)      # Donald Trump x sexo
comparar_dos_grupos(lb$"P42NC.E", lb$gestion, lb$WT)   # Corrupción Congreso x gestión
comparar_dos_grupos(lb$"P42NC.F", lb$sexo, lb$WT)      # Corrupción sindicatos x sexo
comparar_dos_grupos(lb$"P61ST.1", lb$voto, lb$WT)      # Fidel Castro x voto
comparar_dos_grupos(lb$P11STGBSC, lb$voto, lb$WT)      # Cuán democrático x voto
comparar_varios_grupos(lb$P19STC, lb$educ3, lb$WT)     # Izq-der x educación
comparar_dos_grupos(lb$"P42NC.D", lb$gestion, lb$WT)   # Corrupción municipios x gestión
comparar_varios_grupos(lb$"P42NC.B", lb$educ3, lb$WT)  # Corrupción grandes empresas x educación
comparar_varios_grupos(lb$"P61ST.3", lb$edad4, lb$WT)  # Papa Francisco x edad

# PELA
comparar_varios_grupos(pela$EM1, pela$ideol3, pela$Ponder)     # Estado-mercado x ideología
comparar_varios_grupos(pela$VAL1, pela$ideol3, pela$Ponder)    # Matrimonio igualitario x ideología
comparar_dos_grupos(pela$VAL2, pela$creyente, pela$Ponder)     # Aborto x creyente
comparar_dos_grupos(pela$VAL3, pela$sexo, pela$Ponder)         # Legalización de drogas x sexo
comparar_varios_grupos(pela$FFAA1, pela$ideol3, pela$Ponder)   # Papel de las FF.AA. x ideología
comparar_dos_grupos(pela$RRII2_UE, pela$gob_opo, pela$Ponder)  # TLC con la UE x gobierno/oposición
comparar_dos_grupos(pela$EM1, pela$sexo, pela$Ponder)          # Estado-mercado x sexo


# ---------------------------------------------------------------------
# 5. TU TURNO
#    Elegí una variable numérica (escala) y una variable que arme grupos,
#    y reemplazalas en la línea de abajo.
# ---------------------------------------------------------------------
# comparar_dos_grupos(lb$P11STGBSC, lb$gestion, lb$WT)
Sintaxis completa de SPSS
Abrí la base (Archivo > Importar datos > Datos CSV; en Latinobarómetro el delimitador es el punto y coma, y en las dos bases el decimal es el punto). Después abrí la sintaxis, seleccioná un bloque y ejecutalo.
* =====================================================================.
*  MÉTODOS CUANTITATIVOS — COMPARACIÓN DE MEDIAS.
*  Sintaxis completa de SPSS.
*  Bases: Latinobarómetro Argentina 2017 y PELA Argentina 2017 (ponderadas).
* =====================================================================.
*
*  Cómo usarla:
*  1. Abrí la base con Archivo > Importar datos > Datos CSV.
*     Latinobarómetro: el delimitador es el punto y coma (;).
*     En las dos bases, el separador decimal es el PUNTO.
*  2. Abrí esta sintaxis (Archivo > Abrir > Sintaxis).
*  3. Seleccioná un bloque y ejecutalo con el triángulo verde (o Ctrl + R).
*
*  Cómo leer la salida de la prueba t:
*  en la tabla "Prueba de muestras independientes" leé SIEMPRE la fila
*  "No se asumen varianzas iguales". Las primeras columnas (Levene) no se usan.
*
*  La receta de toda la clase:
*  PASO 1. Mirar los promedios de cada grupo.
*  PASO 2. ¿Sig. (p) es menor a 0,05?  Si NO: no se sigue leyendo.
*  PASO 3. ¿La diferencia supera el 5% del promedio más bajo?
*          Cálculo: diferencia dividida por el promedio más bajo.
*  Ojo: para comparar escalas distintas (0 a 10 con 1 a 10), primero hay que llevarlas a la misma escala.
* =====================================================================.


* =====================================================================.
*  PARTE A — LATINOBARÓMETRO ARGENTINA 2017 (abrir esta base primero).
* =====================================================================.

* Los códigos negativos son "no sabe", "no responde", "no conoce": perdidos.
MISSING VALUES P11STGBSC P19STC P42NC.A P42NC.B P42NC.C P42NC.D P42NC.E P42NC.F
  P61ST.1 P61ST.2 P61ST.3 P17STGBSC (LO THRU -1).

* Nombres de los grupos.
VALUE LABELS SEXO 1 'Varones' 2 'Mujeres'
  /P17STGBSC 1 'Aprueba la gestión' 2 'No aprueba la gestión'
  /REEDAD 1 '16 a 25' 2 '26 a 40' 3 '41 a 60' 4 '61 y más'.

* Educación en tres grupos.
RECODE REEDUC.1 (1 THRU 3=1) (4 THRU 5=2) (6 THRU 7=3) INTO educ3.
VALUE LABELS educ3 1 'Baja' 2 'Media' 3 'Alta'.

* Intención de voto: Frente para la Victoria o Cambiemos.
RECODE P16STGBS (32001=1) (32044=2) (ELSE=SYSMIS) INTO voto.
VALUE LABELS voto 1 'FPV' 2 'Cambiemos'.
EXECUTE.

* Ponderar la base.
WEIGHT BY WT.

* ---------------------------------------------------------------------.
* CASO 1 — Significativa pero chiquita.
* Corrupción en los Tribunales de Justicia (0 a 10) según sexo.
T-TEST GROUPS=SEXO(1 2)
  /VARIABLES=P42NC.A
  /CRITERIA=CI(.95).

* CASO 2 — Significativa y grande.
* Corrupción en el Gobierno Nacional (0 a 10) según aprueba o no la gestión.
T-TEST GROUPS=P17STGBSC(1 2)
  /VARIABLES=P42NC.C
  /CRITERIA=CI(.95).

* CASO 3 — No significativa.
* Cuán democrático es el país (1 a 10) según sexo.
T-TEST GROUPS=SEXO(1 2)
  /VARIABLES=P11STGBSC
  /CRITERIA=CI(.95).

* CASO 4 — Más de dos grupos: ANOVA.
* Autoubicación izquierda (0) - derecha (10) según edad.
* La tabla "Tabla de ANOVA" trae la Sig.; la tabla "Medidas de asociación" trae eta cuadrado (perlita).
MEANS TABLES=P19STC BY REEDAD
  /CELLS=MEAN COUNT STDDEV
  /STATISTICS ANOVA.

* CASO 7 — La lectura trampa: el caso 1, por separado en dos grupos de edad.
* Jóvenes (16 a 25).
TEMPORARY.
SELECT IF (REEDAD = 1).
T-TEST GROUPS=SEXO(1 2)
  /VARIABLES=P42NC.A
  /CRITERIA=CI(.95).
* Adultos (41 a 60).
TEMPORARY.
SELECT IF (REEDAD = 3).
T-TEST GROUPS=SEXO(1 2)
  /VARIABLES=P42NC.A
  /CRITERIA=CI(.95).

* PERLITA — Eta cuadrado con dos grupos (caso 2).
MEANS TABLES=P42NC.C BY P17STGBSC
  /CELLS=MEAN COUNT STDDEV
  /STATISTICS ANOVA.

* ---------------------------------------------------------------------.
* Cruces del banco de ejercicios (Latinobarómetro).
* Papa Francisco (0 a 10) según gestión.
T-TEST GROUPS=P17STGBSC(1 2) /VARIABLES=P61ST.3 /CRITERIA=CI(.95).
* Donald Trump (0 a 10) según sexo.
T-TEST GROUPS=SEXO(1 2) /VARIABLES=P61ST.2 /CRITERIA=CI(.95).
* Corrupción en el Congreso (0 a 10) según gestión.
T-TEST GROUPS=P17STGBSC(1 2) /VARIABLES=P42NC.E /CRITERIA=CI(.95).
* Corrupción en los sindicatos (0 a 10) según sexo.
T-TEST GROUPS=SEXO(1 2) /VARIABLES=P42NC.F /CRITERIA=CI(.95).
* Fidel Castro (0 a 10) según intención de voto.
T-TEST GROUPS=voto(1 2) /VARIABLES=P61ST.1 /CRITERIA=CI(.95).
* Cuán democrático es el país (1 a 10) según intención de voto.
T-TEST GROUPS=voto(1 2) /VARIABLES=P11STGBSC /CRITERIA=CI(.95).
* Corrupción en las municipalidades (0 a 10) según gestión.
T-TEST GROUPS=P17STGBSC(1 2) /VARIABLES=P42NC.D /CRITERIA=CI(.95).
* Autoubicación izquierda-derecha (0 a 10) según educación.
MEANS TABLES=P19STC BY educ3 /CELLS=MEAN COUNT STDDEV /STATISTICS ANOVA.
* Corrupción en las grandes empresas (0 a 10) según educación.
MEANS TABLES=P42NC.B BY educ3 /CELLS=MEAN COUNT STDDEV /STATISTICS ANOVA.
* Papa Francisco (0 a 10) según edad.
MEANS TABLES=P61ST.3 BY REEDAD /CELLS=MEAN COUNT STDDEV /STATISTICS ANOVA.


* =====================================================================.
*  PARTE B — PELA ARGENTINA 2017 (abrir la base de diputados).
* =====================================================================.

* 98 = no sabe, 99 = no contesta, 999 = sin dato: perdidos.
MISSING VALUES RRII2_US RRII2_UE VAL1 VAL2 VAL3 EM1 FFAA1 (98 THRU HI).
MISSING VALUES IDEOL_5_3 POL1 RE1 SOCD4 (9 THRU HI).

VALUE LABELS SOCD4 1 'Diputados' 2 'Diputadas'
  /IDEOL_5_3 1 'Izquierda' 2 'Centro' 3 'Derecha'
  /POL1 1 'Oficialistas' 2 'Opositores'
  /RE1 1 'Creyentes' 2 'No creyentes'.
EXECUTE.

WEIGHT BY Ponder.

* CASO 5 — Grande aun con pocos casos.
* Valoración de un Tratado de Libre Comercio con EE.UU. (1 a 10) según ideología.
MEANS TABLES=RRII2_US BY IDEOL_5_3
  /CELLS=MEAN COUNT STDDEV
  /STATISTICS ANOVA.

* CASO 6 — Parece grande pero no alcanza.
* Aprobación del matrimonio entre personas del mismo sexo (1 a 10) según sexo.
T-TEST GROUPS=SOCD4(1 2)
  /VARIABLES=VAL1
  /CRITERIA=CI(.95).

* CASO 8 — Paralelo elites / ciudadanos.
* TLC con EE.UU. (1 a 10) según oficialistas u opositores.
T-TEST GROUPS=POL1(1 2)
  /VARIABLES=RRII2_US
  /CRITERIA=CI(.95).

* ---------------------------------------------------------------------.
* Cruces del banco de ejercicios (PELA).
* Estado (1) - mercado (10) según ideología.
MEANS TABLES=EM1 BY IDEOL_5_3 /CELLS=MEAN COUNT STDDEV /STATISTICS ANOVA.
* Matrimonio igualitario (1 a 10) según ideología.
MEANS TABLES=VAL1 BY IDEOL_5_3 /CELLS=MEAN COUNT STDDEV /STATISTICS ANOVA.
* Aborto (1 a 10) según creyente o no.
T-TEST GROUPS=RE1(1 2) /VARIABLES=VAL2 /CRITERIA=CI(.95).
* Legalización de drogas (1 a 10) según sexo.
T-TEST GROUPS=SOCD4(1 2) /VARIABLES=VAL3 /CRITERIA=CI(.95).
* Papel de las Fuerzas Armadas (1 a 10) según ideología.
MEANS TABLES=FFAA1 BY IDEOL_5_3 /CELLS=MEAN COUNT STDDEV /STATISTICS ANOVA.
* TLC con la Unión Europea (1 a 10) según oficialistas u opositores.
T-TEST GROUPS=POL1(1 2) /VARIABLES=RRII2_UE /CRITERIA=CI(.95).
* Estado-mercado (1 a 10) según sexo.
T-TEST GROUPS=SOCD4(1 2) /VARIABLES=EM1 /CRITERIA=CI(.95).

* ---------------------------------------------------------------------.
* TU TURNO: cambiá la variable numérica (VARIABLES=) y la de grupos (GROUPS=).
* T-TEST GROUPS=POL1(1 2) /VARIABLES=EM1 /CRITERIA=CI(.95).
Bases y documentación
Variables usadas en la clase
| Base | Variable | Qué mide |
|---|---|---|
| Latinobarómetro | P42NC.A … P42NC.F | Corrupción en Tribunales, grandes empresas, Gobierno Nacional, municipalidades, Congreso, sindicatos (0 a 10) |
| Latinobarómetro | P11STGBSC | Cuán democrático es el país (1 a 10) |
| Latinobarómetro | P19STC | Autoubicación izquierda (0) – derecha (10) |
| Latinobarómetro | P61ST.1 / .2 / .3 | Evaluación de Fidel Castro / Donald Trump / Papa Francisco (0 a 10) |
| Latinobarómetro | SEXO, REEDAD, REEDUC.1, P17STGBSC, P16STGBS | Sexo, edad en tramos, educación, aprobación de la gestión, intención de voto |
| Latinobarómetro | WT | Ponderador |
| PELA | RRII2_US / RRII2_UE | Valoración del TLC con EE.UU. / con la Unión Europea (1 a 10) |
| PELA | VAL1 / VAL2 / VAL3 | Matrimonio entre personas del mismo sexo / aborto / legalización de drogas (1 a 10) |
| PELA | EM1 / FFAA1 | Estado (1) – mercado (10) / papel de las Fuerzas Armadas (1 a 10) |
| PELA | SOCD4, IDEOL_5_3, POL1, RE1 | Sexo, ideología (izq./centro/der.), gobierno u oposición, creyente |
| PELA | Ponder | Ponderador |